Il monitoraggio IT proattivo raccoglie segnali su PC, server e servizi e li confronta con condizioni definite. Quando emerge un problema, deve attivare una risposta con un responsabile e una priorità. Il suo valore dipende da ciò che accade dopo la segnalazione.
Per una PMI in Ticino, la domanda utile è concreta: se il backup fallisce o il server si avvicina al limite dello spazio, chi se ne accorge, chi interviene e come verifica il risultato? Una schermata verde, da sola, non risponde. Questa guida propone criteri per organizzare i controlli e distinguere gli avvisi utili dal rumore.
Che cosa comprende il monitoraggio IT proattivo?
Una piattaforma RMM, cioè di monitoraggio e gestione da remoto, può raccogliere informazioni dai dispositivi e offrire funzioni di amministrazione. Il perimetro effettivo dipende dallo strumento, dalle configurazioni e dai sistemi collegati. Un PC presente nell'inventario potrebbe non comunicare più; un servizio applicativo potrebbe essere escluso dai controlli.
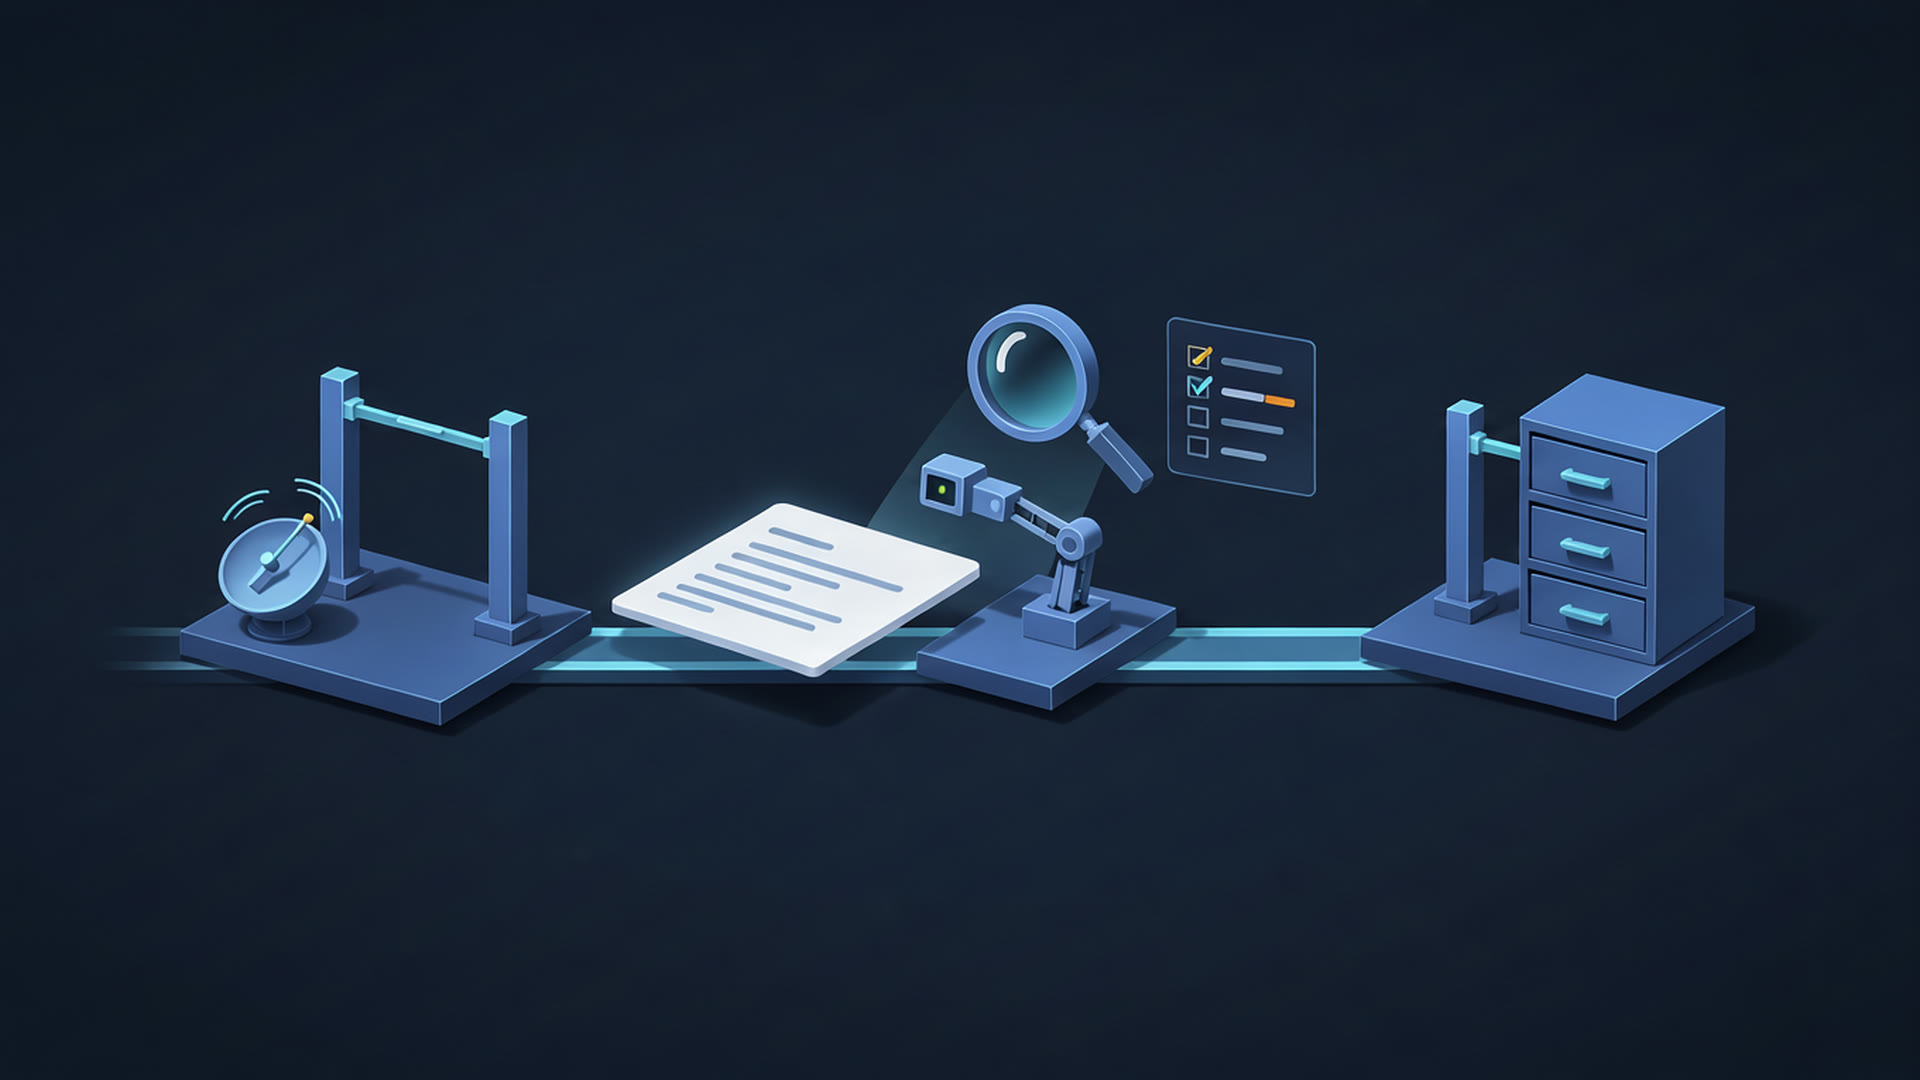
Occorre distinguere tre attività: rilevare una condizione, avvisare una persona e correggere il problema. Nell'esempio di Azure Monitor, le regole di allarme valutano segnali e condizioni sulle risorse configurate. Notifiche e azioni dipendono dalle associazioni impostate. Il semplice acquisto di uno strumento non definisce quindi il servizio di assistenza.
Quali controlli servono su PC e server?
Il punto di partenza è un inventario che colleghi ogni dispositivo al suo utilizzo e a un referente. Per organizzare la prima valutazione proponiamo questa mappa:
| Area | Informazione da verificare | Domanda operativa |
|---|---|---|
| Comunicazione | Ultimo dato ricevuto | Stiamo osservando una situazione attuale? |
| Risorse | Spazio e andamento delle prestazioni | Quale attività aziendale rischia di fermarsi? |
| Aggiornamenti | Installazioni, errori e riavvii | La protezione prevista è realmente applicata? |
| Backup | Esito, ultimo punto disponibile e ripristino | Quali dati possiamo recuperare? |
| Sicurezza | Stato della protezione e dei sensori | Il sistema continua a rilevare gli eventi? |
Dispositivi che smettono di comunicare
Il controllo deve includere la freschezza dei dati. Nei report di conformità Intune, per esempio, le informazioni dipendono dal contatto del dispositivo con il servizio e possono non riflettere subito cambiamenti recenti. Una segnalazione mancante non dimostra che il PC sia sano.
Va distinto un portatile spento durante un'assenza da un server che dovrebbe essere operativo. Associare orario e funzione del dispositivo evita di trattare allo stesso modo situazioni diverse.
Spazio e prestazioni
Per i dischi contano spazio disponibile, velocità di crescita dei dati e conseguenze sull'applicazione. Una soglia percentuale identica su tutti i sistemi può produrre segnalazioni poco utili: vanno considerate capacità e carico effettivi.
Per CPU, memoria e accesso ai dischi è utile osservare l'andamento nel tempo e il contesto del rallentamento. La guida Microsoft a Performance Monitor illustra la raccolta dei contatori per analizzare i colli di bottiglia. Un picco breve durante un'elaborazione prevista richiede una valutazione diversa da un problema persistente durante il lavoro.
Aggiornamenti e riavvii
Il rapporto deve distinguere un aggiornamento previsto, scaricato, installato o fallito. Negli ambienti Microsoft, i report Intune sugli aggiornamenti permettono di analizzare stati ed errori dei dispositivi gestiti.
Anche il riavvio è parte della procedura. I criteri degli anelli di aggiornamento prevedono impostazioni per installazioni, orari e comportamento dei riavvii. Un riavvio che interrompe un'attività critica deve essere gestito nel piano operativo, con comunicazione e verifica successiva. Funzioni e requisiti vanno controllati per il proprio ambiente.
Backup e possibilità di recupero
Per ogni insieme di dati importante occorre sapere se il processo è terminato, quando è disponibile l'ultimo punto di recupero e se esistono errori da risolvere. La documentazione di monitoraggio Azure Backup distingue controllo dei processi, stato della protezione, allarmi e analisi storica.
Il successo del processo e la possibilità di riprendere il lavoro sono verifiche differenti. Proponiamo di affiancare ai controlli automatici prove di ripristino concordate, con dati e applicazioni rappresentativi. Il verbale deve indicare cosa è stato recuperato e quale risultato è stato osservato: non basta registrare che il test è stato avviato.
Protezione endpoint e salute dei sensori
Oltre allo stato dell'antivirus, va controllata la capacità dello strumento di comunicare. Microsoft distingue in Defender for Endpoint dispositivi attivi, inattivi o con problemi di configurazione e comunicazione. Un sensore che non invia dati può limitare segnalazioni e azioni disponibili.
Questi stati vanno investigati in relazione al dispositivo. Non equivalgono automaticamente a un'infezione, né consentono di escluderla. Il controllo tecnico deve produrre un'azione pertinente, senza rassicurazioni basate soltanto sull'assenza di notifiche.
Quali avvisi conviene ridurre?
Gli allarmi ripetuti per una stessa causa, i picchi già spiegati e le notifiche durante una manutenzione concordata possono rendere difficile riconoscere gli eventi importanti. Prima di ridurli, bisogna verificarne origine e conseguenze.
Per gli ambienti Azure, le regole di elaborazione degli allarmi consentono di modificare l'inoltro delle notifiche, anche secondo intervalli pianificati. La sospensione delle notifiche è distinta dalla disattivazione delle regole di rilevamento. Una finestra di manutenzione deve avere un perimetro e una fine definiti; al termine va verificato il ripristino del normale flusso.
Come assegnare priorità e responsabilità
Una priorità utile descrive l'impatto sul lavoro. Proponiamo una classificazione iniziale da adattare all'azienda:
| Situazione esemplificativa | Valutazione proposta |
|---|---|
| Servizio essenziale indisponibile | Verifica tempestiva dell'impatto e attivazione del referente previsto |
| Backup ripetutamente fallito, lavoro ancora possibile | Presa in carico e verifica dell'esposizione prima di rimandare |
| Capacità in riduzione senza impatto attuale | Intervento pianificato e controllo dell'andamento |
Sono esempi organizzativi, non tempi di risposta garantiti. Per ciascuna categoria vanno concordati destinatario, sostituto, orario coperto e modalità di escalation se nessuno prende in carico l'evento.
In Azure, i gruppi di azioni collegano allarmi, notifiche e azioni configurate. Anche con altri strumenti bisogna verificare la catena completa: un messaggio generato non dimostra che sia stato ricevuto o che qualcuno stia lavorando al problema.
Quando è appropriata una correzione automatica?
Alcune anomalie possono essere gestite con procedure definite. Le Remediations di Microsoft Intune, per esempio, distinguono rilevazione e correzione tramite pacchetti di script, con requisiti di dispositivo, licenza e autorizzazione.
L'automazione va provata su un gruppo limitato e accompagnata da registrazione dell'esito. Vanno definiti ambito, numero massimo di tentativi e condizioni per interrompersi. Se la correzione non funziona, l'evento deve passare a un referente invece di ripetersi senza fine.
Per azioni che possono interrompere il lavoro o modificare dati serve un'autorizzazione operativa appropriata. Il controllo successivo deve verificare il servizio interessato: un comando terminato senza errori non prova, da solo, che il problema dell'utente sia risolto.
Una prova concreta prima di estendere il servizio
Immaginiamo una PMI con PC amministrativi, portatili e un server per i documenti. È un esempio di progetto, senza risultati cliente attribuiti. Il referente sceglie un dispositivo di prova e un servizio non critico, concordando quali eventi simulare senza mettere a rischio dati o attività.
Si può verificare la ricezione di una notifica di test, la presa in carico e l'aggiornamento della richiesta. Poi si controlla come appare un dispositivo previsto come indisponibile e se la sua assenza viene interpretata correttamente. Una prova del backup richiede invece un recupero concordato in una destinazione di test.
Per ciascun caso si annotano condizione iniziale, segnale osservato, destinatario, azione eseguita ed esito finale. Se il messaggio arriva alla persona sbagliata o manca un sostituto, si corregge il percorso e si ripete quella verifica. Questa scheda rende visibili i limiti del servizio prima dell'estensione agli altri dispositivi.
Se il progetto comprende un passaggio a Microsoft 365, la checklist di migrazione per una PMI approfondisce prova pilota e verifiche dopo la transizione. Dopo il passaggio, aggiorna anche sistemi e flussi inclusi nel monitoraggio: l'inventario precedente potrebbe descrivere risorse non più utilizzate.
Checklist prima di attivare il monitoraggio
- Inventario aggiornato e responsabilità assegnate per dispositivi e servizi.
- Ultimo contatto visibile e assenze previste riconoscibili.
- Allarmi collegati a conseguenze concrete e priorità concordate.
- Destinatario, sostituto ed escalation verificati con una prova.
- Orari coperti e interventi inclusi descritti nel servizio.
- Correzioni automatiche limitate, provate e tracciate.
- Recupero dei dati verificato con una prova appropriata.
- Accessi ai report e dati raccolti limitati al necessario per il lavoro tecnico.
Nel rapporto periodico chiedi soprattutto problemi ancora aperti, anomalie ricorrenti e interventi completati con esito verificato. Il numero di notifiche inviate, da solo, non misura la qualità dell'assistenza.
Domande frequenti
Monitoraggio continuo significa assistenza tecnica giorno e notte?
La raccolta automatica dei dati può avere un orario diverso dalla presenza di un tecnico. Vanno verificati nel contratto fasce di presa in carico, reperibilità e interventi inclusi. La disponibilità dello strumento non autorizza a promettere assistenza continua.
Una dashboard verde garantisce che tutto funzioni?
Indica lo stato rilevato dai controlli configurati, alla data disponibile. Risorse escluse, dispositivi che non comunicano e applicazioni non verificate possono lasciare problemi fuori dal quadro. Occorre conoscere perimetro e freschezza dei dati.
Bisogna intervenire su ogni picco di CPU?
Un picco va letto insieme a durata, attività in corso e sintomi. Le soglie richiedono una valutazione sul carico reale; copiare gli stessi valori su ogni PC può aumentare le notifiche senza chiarire le priorità.
Qual è il rapporto con la manutenzione IT?
Il monitoraggio può individuare condizioni da affrontare; la manutenzione comprende interventi e verifiche pianificati. Per definire il perimetro del servizio, approfondisci la manutenzione informatica per aziende.
Organizzare controlli e interventi per la tua PMI
ED Solution Tech Sagl può affiancarti nella valutazione di PC, server e procedure. Contattaci per l'assistenza IT in Ticino indicando sistemi utilizzati, problemi ricorrenti e orari operativi: sono informazioni utili per definire controlli e responsabilità pertinenti.
Fonti
Documentazione primaria Microsoft consultata il 27 ottobre 2026. Gli esempi di prodotto richiedono verifica di applicabilità, configurazioni e licenze nell'ambiente aziendale:
- Funzionamento degli allarmi Azure Monitor.
- Report di conformità Intune e aggiornamento dei dati.
- Performance Monitor e analisi dei rallentamenti.
- Report operativi Microsoft Intune.
- Impostazioni di aggiornamento e riavvio.
- Monitoraggio e allarmi Azure Backup.
- Salute dei sensori Defender for Endpoint.
- Elaborazione e sospensione delle notifiche.
- Gruppi di azioni e destinatari.
- Remediations Intune: rilevamento e correzione.